なぜか頭に入ってこない、AIのあの返事
AIに質問して返ってきた文章を読んでいて、途中で目が滑ったことはありませんか?
文法が間違っているわけでもなく、嘘が書いてあるわけでもないのに、なぜか内容が頭に入ってこないことがあります。
私も教室で教材や課題の解説を作っているとき、AIの返答をそのまま読もうとして、思わず同じ文を二度読みしてしまう瞬間があります。
少し前までは、AIの不自然さといえば「日本語としてぎこちない」とか「事実と違うことを平気で言う」といったわかりやすいものでした。
しかし最近の高性能なAIは、日本語も流暢ですし、難しいプログラミングの質問にも筋の通った答えを返してくれます。
それなのに、読んでいるこちらの頭には、なぜか以前より重い負担がかかっている気がするのです。
この引っかかりは、単なる気のせいなのでしょうか。
それとも、AIの文章そのものに、人間の脳を疲れさせる何かが起きているのでしょうか。
2026年10月21日、まさにこの疑問を調べた研究が、査読前の論文を公開するarXiv(アーカイブ)に掲載されました。
ニューヨーク大学のトーマス・ヒカル・クラーク氏と、テキサス大学オースティン校のマティアス・マーティン氏、カイル・マホワルド氏による論文です。
タイトルは「Why is AI-generated language so hard to understand?(AIが生成した言葉は、なぜこれほど理解しにくいのか?)」という、かなり率直なものです。
心理言語学で測った「読みにくさ」の正体
そもそも、人が文章を読むときに「負担」を感じる仕組みを考えたことはありますか?
人間の言葉の理解や脳の負荷を研究する分野を、心理言語学(しんりげんごがく)と呼びます。
この研究チームは、心理言語学で昔から「人が読むときに負担が増える」と知られている特徴を基準に、AIの文章を細かく測定しました。
調査されたのは、文法的な間違いではなく、次の6つの特徴です。
1つ目は、普通の文章にはめったに出てこない珍しい単語の並びです。
次にどんな言葉が来るか予想しにくいと、脳は余計なエネルギーを使います。
2つ目は、主語と動詞など、意味のうえで強く結びつく言葉どうしの距離が遠いことです。
日本語で言えば、「私は、駅前に去年できた、いつも行列ができている小さなパン屋で、焼きたてのクロワッサンを買いました」のような文です。
「私は」と「買いました」のあいだに説明が長く挟まるので、読む人は「私は」を頭に置いたまま、最後まで読み進めることになります。
「駅前に去年できたパン屋は、いつも行列ができています」「私はそこで、焼きたてのクロワッサンを買いました」と二つの文に分ければ、ずっと楽に読めますよね?
3つ目は、名詞を後ろから説明する形(関係節〈かんけいせつ〉)で、区切りの目印になる「that」が省略されていることです。
英語では「友だちが貸してくれた本」を、本を先に置いて「the book that my friend lent me」のように言い、この that が「ここから本の説明が始まります」という合図になります。
日本語にぴったり同じ仕組みはありませんが、感覚としては、助詞を抜いて「友だち貸してくれた本、まだ読んでない」と言うのに近いかもしれません。
意味は通じても、どこで区切って読めばよいのか、一瞬考えることになります。
4つ目は、名詞が3つも4つも連続してつながっていることです。
日本語で言えば、「子ども写真コンテスト審査基準」のような言葉です。
短く言える代わりに、「子どもが撮った写真」なのか「子どもを写した写真」なのか、名詞どうしの関係を読む人が補わなければなりません。
5つ目は、名詞をその場で無理やり動詞として使うことです。
日本語で言えば、「その予定、カレンダーしといて」(カレンダーに入れておいて)のような言い方です。
6つ目は、生き物ではない主語に、生き物のような動作をさせることです。
「この関数がエラーを飲み込む」「この構造が噛みつく」といった表現です。
これらはいずれも、言葉のルールとして間違っているわけではありません。
しかし、どれも「丁寧に言い換えると長くなるところを、短くギュッと凝縮して言える代わりに、読む側の作業メモリを削る」という共通点を持っています。
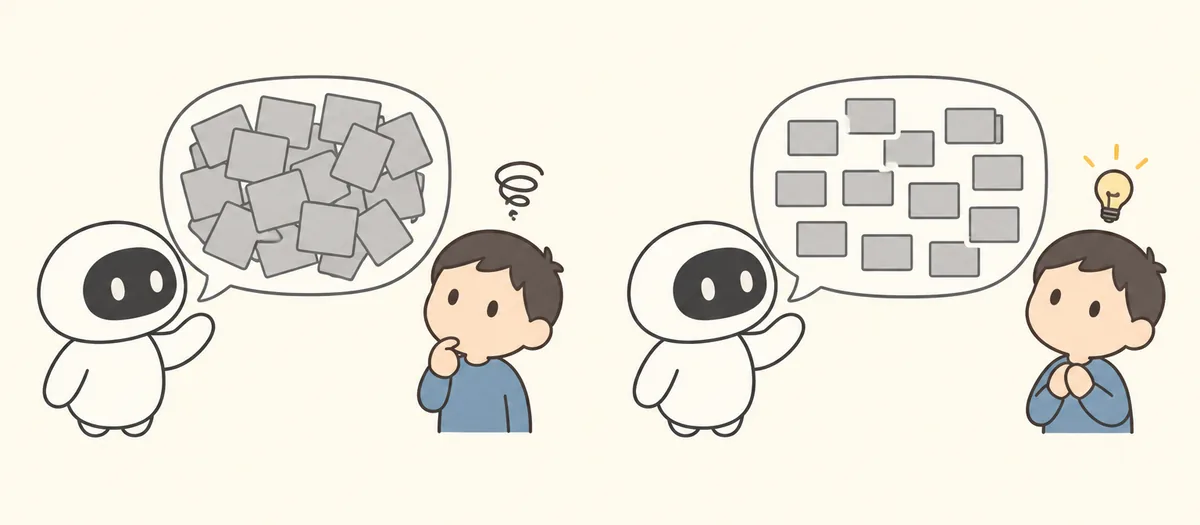
研究チームは、Claude(クロード)のSonnet(ソネット)5やOpus(オーパス)5、GPT(ジーピーティー)-5.6の各モデルなど、最先端の9モデルを含む合計14のAIモデルを調べました。
日常的なチャット、プログラミングのリポジトリ修正、学生向けの作文という3つの場面で文章を書かせ、人間の書いた文章と比較したのです。
すると、最先端の9モデルすべてにおいて、人間の文章よりも「生き物でない主語に生き物の動作をさせる表現」と「珍しい単語の並び」が明らかに多く見られました。
さらにチャットのやり取りでは、ほとんどのモデルで言葉どうしの距離が引き伸ばされ、名詞が詰め込まれ、つなぎの言葉が省かれていたのです。
情報を詰め込むほど、文体は変わっていく
でも、ここで一つ疑問が浮かびます。
AIは、もっとやさしい別の言い方を知らないから、そんな硬くて密度の高い文を書いているのでしょうか?
研究チームは、AIの英文を一度「英語から日本語へ翻訳し、それをもう一度英語に戻す」という往復翻訳にかけました。
日本語のように構造の遠い言語を経由させると、同じ意味を保ったまま、表現の偏りがほぐれるからです。
その結果、往復翻訳を通した後の文章では、名詞の動詞化やつなぎ言葉の省略が減りました。
つまりAIは、同じ意味をもっと普通の言い回しで書くこともできたのに、読みにくい形のほうを選んでいたことになります。
なぜ最新のモデルは、そんな選び方をするのでしょうか。
ひとつのヒントになるのが、モデルごとの比較です。
公開されているモデルであるOlmo(オルモ)の変化を見ると、素のモデル、指示に従う調整(指示調整)を施したモデル、さらに推論向けに訓練された「Olmo Think」へと進むにつれて、この詰め込み傾向が段階的にはっきり強くなっていました。
論文の著者たちは、その理由がAIを賢くするための訓練方法にあると見ています。
最近のAIは、数学やプログラミング、複雑な論理パズルなどの問題を解き、「正解ならポイントを与える」という強化学習(RLVR〈アールエルブイアール〉、検証可能な報酬による強化学習)で急速に能力を伸ばしています。
そこでは「正解にたどり着いたかどうか」だけが厳密に判定され、「人間にとって心地よく読めるか」は評価されません。
加えて、AIが一度に処理できる文字数には上限があり、文字数が多くなるほど計算の費用も跳ね上がります。
その結果、AIの内側で「できるだけ短い言葉に、できるだけ多くの情報を詰め込んで正解を出す」という圧力がかかり続けたのではないか、というのです。
「でも、AIの返事ってむしろ長すぎない?」と思った人もいるかもしれません。
実は、人間が答えを採点して訓練する方法(RLHF〈アールエルエイチエフ〉)では、長い答えに高い点がつきやすいことが別の研究で示されています。
今回の論文はこの点を踏まえて、詰め込みの圧力は人間の採点より「正解なら報酬」型の訓練と結びつきやすいと考えています。
どちらの訓練の影響が強く出るかで、AIの返事は長くもなれば、詰め込みにもなります。
そう考えると、二つの不満は矛盾しません(ただし、ここは著者も推測として書いている部分です)。
研究チームは、Qwen(クウェン)2.5-1.5B-Instructという小型のモデルを使って、小さな原理実験も行っています。
「誰が・何を・どうした」をまとめたデータを英語の文にする課題で、「答えが長いほど減点する」というペナルティをほんの少し加えました。
「短く書け」とも「接続詞を省け」とも一切指示していません。
それなのにAIは、長い言い方と短い言い方の両方を選べる場面で、that などの省ける言葉を落とした短い言い方を、ほぼ必ず選ぶようになりました(モデルを元の状態から離れにくくする調整を入れない条件では98%以上)。
しかも、訓練では見せていない似た種類の言い回しにまで、その省略のクセが広がりました。
人間なら文脈によって that を入れたり省いたりしますが、このモデルは文脈に関係なく短いほうを選ぶようになったのです。
もちろん、これは小さなモデルによる限定的な実験であり、最先端の大規模なAIが読みにくくなった決定的な証拠だとまでは言い切れません。
著者たちも、この実験は原理を示すためのものだと位置づけています。
まったく別の種類の言い換えでは、短いほうへ移ったのは4つのうち1つだけでした。
しかし、コストや正解の効率を追い求めた結果、人間への気配りが文体から抜け落ちていく様子は、背筋が少し寒くなるほど合理的です。
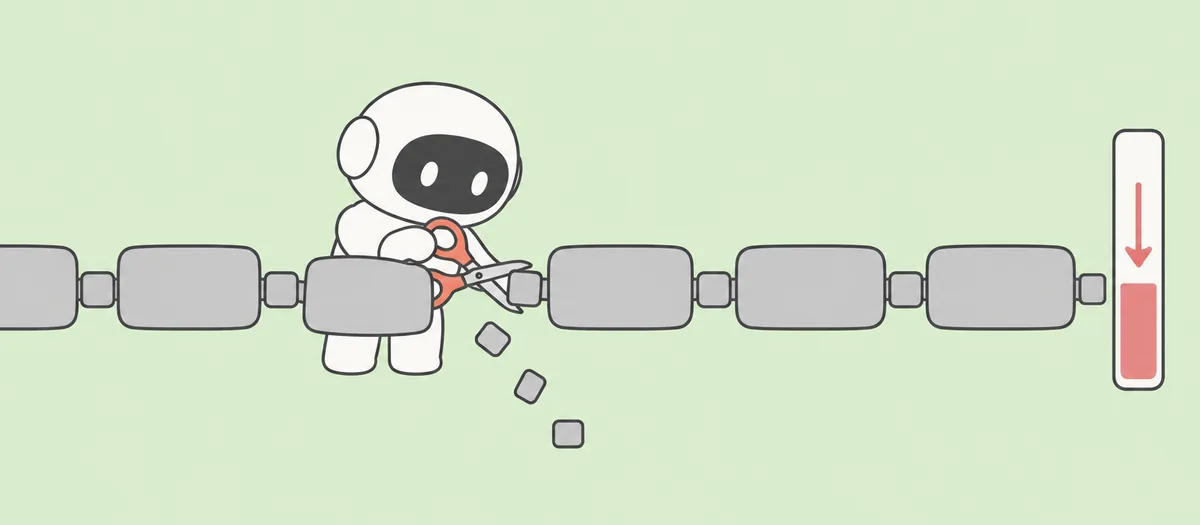
短い変数名と、電報のルール
この「短く詰め込む圧力」と「読む人の負担」の関係は、AIに限った話ではありません。
歴史を振り返ると、人間も同じような場面で文体を変えてきました。
たとえば、かつての電報です。
電報は送る文字数に応じて料金が上がったため、「チチキトク スグカエレ」のように、助詞やつなぎの言葉を徹底的に削った独特の表現が使われました。
文字数を圧縮する強い制約がかかると、言葉の形そのものが変わってしまうのです。
ただし電報の場合は、受け取る側も「これは電報だから」と暗黙のルールを共有していました。
ところが現代のAIは、電報のような圧縮文体を、日常会話の顔をして私たちに手渡してきます。
私たちが感じる違和感の一因は、ここにあるのではないかと私は考えています。
新聞の見出しも似ています。
限られた紙面の横幅に情報を詰め込むため、英語の新聞では名詞をやたらと積み重ねる表現がよく使われます。
今回の論文でも、有名な「Squad Helps Dog Bite Victim」という英語の見出しが紹介されていました。
名詞がぎゅうぎゅうに並んでいるせいで、「救助隊が、犬に噛まれた被害者を助けた」とも読めますし、「救助隊が、犬が被害者に噛みつくのを手伝った」という恐ろしい意味にも文法上は読めてしまうのです。
プログラミングを学んでいるときにも、まったく同じことが起きます。
プログラムを書き始めたばかりの人は、変数名をつけるときに「a」とか「tmp」とか「data2」といった短い名前をつけがちです。
キーボードを打つ文字数が少なくて済みますし、書いているその瞬間は、自分の頭の中に意味が入っているからです。
ですが、そのコードを数週間後の自分や、教室の別の生徒が読むと、何が入っているのかさっぱり分からず、前後のコードを読み返して解読することになります。
プログラミングの世界には「コードは書く時間よりも、読まれる時間のほうが圧倒的に長い」という有名な格言があります。
だからこそ私たちは、多少文字数が増えて長くなったとしても、誰が読んでも一目で意味が伝わる丁寧な名前をつけるように指導します。
書く側の効率だけを優先して極端に圧縮した表現は、読む側のメモリを奪ってしまうからです。
人間の言葉は、聞き手に合わせてできている
本来、人間の言語はどうやって形づくられてきたのでしょうか。
言語学者のフットレル氏らが2015年に発表した37言語の大規模な研究では、調べた37の言語のすべてで、関係の深い言葉どうしの距離を短くする傾向があることが示されています。
ちなみにこの研究には、今回の論文の著者の一人であるマホワルド氏も加わっています。
人間には、一度に記憶しておける情報量に限界があります。
だからこそ人類は、聞き手の頭がパンクしないよう、情報が一か所に詰まりすぎないよう言葉を補いながら、伝わりやすさを最優先にして言葉の文法を磨いてきました。
一方で、現代の推論AIは、人間の聞き手ではなく「正解の正確さ」と「計算の効率」に向かって最適化されつつあります。
別の研究チームであるラインハート氏らの2025年の論文でも、指示に従うよう調整されたAIは、人間の文章に比べて名詞化を1.5〜2倍の割合で使い、名詞の多い密な文体になっていたことが報告されています。
AIの文章が読みにくいのは、言葉が下手になったからではなく、人間が言葉を発するときとは別の力学で文章が書かれているからかもしれません。
分かりにくさを、自分のせいにしないために
この見方を知っておくことは、子どもたちや学生にとって、思わぬ助けになると私は感じています。
教室で子どもたちを見ていると、AIに質問して返ってきた解説を読みながら、「難しくてよく分からない」「自分の頭が悪いのかな」と落ち込んでしまう子がいます。
真面目な子ほど、読めないのを自分の理解力不足のせいにしてしまうのです。
ですが、もし「最新のAIは、計算の都合で言葉をぎゅっと詰め込みすぎるクセがあるんだよ」と知っていたらどうでしょうか。
分かりにくさの原因が、自分の頭だけにあるわけではないと考えられます。
そう思えるだけで、子どもたちは自信を失わずに、「もっとやさしい言葉で説明して」「一文を短く分けて教えて」と、AIに対して堂々と注文を出し直せるようになります。
人間の記憶に合わせて書くということ
今回の研究は英語を対象としたものであり、日本語のAI出力にそのままどこまで当てはまるかは、まだ慎重に見極める必要があります。
また、すべての最新モデルが同じように悪化しているわけではありません。
実際に今回の論文でも、Claudeの「Opus 5.5」は、ひとつ前の「Opus 5」と比べて、読みにくさに関する指標の21項目中19項目で値が下がったと報告されています。
著者たちはこの結果を、伝わりやすさを評価に入れて訓練すれば文体を読みやすい方向へ戻せる例だと見ています。
ただ、私たちが日常でAIを使うときには、いま目の前にある出力を受け止めなければなりません。
もしAIの返答を読んでいて少しでも引っかかりを感じたら、無理をしてそのまま読み進めるのをやめてみてください。
「中学生にもスッと頭に入るように書き直して」「省略した主語やつなぎの言葉を補って」と頼み直すと、読みやすくなることが多いです。
そしてもうひとつ、仕事や勉強でAIの文章を誰かに送るときは、送信ボタンを押す前に一呼吸置いてみてください。
AIが省いてしまった接続詞を足したり、ぎゅうぎゅうに詰め込まれた一文を二つに分けたりする作業は、今のところ人間側の手元に残されています。
相手の頭の容量を想像し、相手の記憶に負担をかけないように言葉をほどいて渡すこと。
それはプログラミングで読みやすいコードを書くこととも、まったく地続きの技術です。
AIがどれほど賢く答えを出せるようになっても、その答えを受け取る相手が人間である限り、「読み手の記憶に配慮して伝える力」の価値は、静かに残り続けるのではないでしょうか。
参考文献
・Thomas Hikaru Clark, Matias B. Martin, Kyle Mahowald. (2026). "Why is AI-generated language so hard to understand?" arXiv:2610.29162.
・Richard Futrell, Kyle Mahowald, Edward Gibson. (2015). "Large-scale evidence of dependency length minimization in 37 languages." Proceedings of the National Academy of Sciences (PNAS).
・Alex Reinhart, et al. (2025). "Do LLMs write like humans?" Proceedings of the National Academy of Sciences (PNAS).
・Prasann Singhal, et al. (2023/2024). "A Long Way to Go: Investigating Length Correlations in RLHF." arXiv:2310.03716.